Jev — 문장을 만들지 않는 결정 모델
소개 시점: · System One Models·Jev 소개 및 early access 공개
- 자동화에는 긴 답변보다 “어느 팀에 보낼까?” 같은 작은 판단이 반복해서 필요하다.
- Jev는 문장 대신 미리 정한 선택지·점수·확률을 돌려주어 코드가 다음 행동을 정하게 하는 모델이다.
- 답변 작성과 복잡한 추론은 LLM(대형 언어 모델)에, 분류와 채점은 Jev에 나눠 맡기는 것이 이 제품의 접근이다.
- 답의 형식이 맞아도 판단은 틀릴 수 있다. 확률과 confidence는 보류·사람 검토를 정하는 재료다.
고객이 “주문할 때마다 오류가 나요”라고 보냈다고 하자. 담당 팀을 정하는 프로그램에 필요한 것은
긴 설명보다 technical이라는 값이다. 답장을 작성하는 능력과 다음 코드 분기를 정하는 능력은 쓰임새가 다르다.
TypeSafe의 Jev 소개는 이 차이에서 출발한다. Jev는 에이전트 전체를 대신하는 제품이 아니라, 그 안에서 작은 판단을 맡길 수 있는 모델이다. 이 페이지의 질문은 **“문장 생성 대신 판단에 집중하면 무엇이 달라지고, 무엇은 여전히 코드가 해야 할까?”**다.
이 장에서 처음 나오는 말3개
결정 모델decision model- 문장이나 코드를 쓰는 대신 분류·점수 같은 판단 값을 돌려주는 모델.
state- 판단에 필요한 재료. 고객 문의 본문, 주문 정보, 정책 등을 담는다.
confidence- 선택지별 확률이 얼마나 한쪽에 모였는지를 나타내는 값. 정답률과 같은 숫자는 아니다.
큰 그림: 판단은 모델이, 다음 행동은 코드가
섹션 제목: “큰 그림: 판단은 모델이, 다음 행동은 코드가”
그림의 마지막 두 상자를 구별하면 된다. Jev가 “기술팀일 가능성이 높다”는 값을 돌려주면, 실제로 기술팀에 배정할지, 사람이 먼저 검토할지는 애플리케이션 코드가 정한다. 모델이 티켓을 옮기거나 환불을 실행하는 것은 아니다.
문제의식: 자동화의 작은 판단마다 긴 답변이 필요한가
섹션 제목: “문제의식: 자동화의 작은 판단마다 긴 답변이 필요한가”프로그램은 설명보다 정해진 값을 원한다
섹션 제목: “프로그램은 설명보다 정해진 값을 원한다”일반 LLM에도 담당 팀을 물을 수 있다. 자유로운 문장으로 받으면 답에서 팀 이름을 추출해야 하고, 구조화 출력으로 받으면 정해진 필드를 읽을 수 있다. 따라서 “LLM은 JSON을 못 만든다”가 Jev의 출발점은 아니다.
TypeSafe가 집중한 것은 선택·채점만 필요한 호출에 문장 생성 중심의 모델을 계속 써야 하는가다. Jev의 질문 형식은 처음부터 가능한 답의 범위를 정하게 한다. 덕분에 생성된 설명에서 값을 다시 찾아내는 처리를 줄일 수 있다. HTTP 응답을 읽거나 통신 오류를 재시도하는 일, 결과가 업무상 맞는지 확인하는 일은 여전히 남는다.
자신 있게 말하는 것과 잘 맞는 것은 다르다
섹션 제목: “자신 있게 말하는 것과 잘 맞는 것은 다르다”모델이 “확실합니다”라고 말한다고 자동 처리해도 되는 것은 아니다. 자동화에는 애매한 입력을 사람에게 돌릴 기준이 필요하다. TypeSafe의 학습 설명은 사람이 좋아할 답을 만드는 목표와, 실제 결과에 맞는 확률을 내는 목표를 구별한다.
후자를 **calibration(확률 보정)**이라고 한다. 예를 들어 정답일 확률을 0.9로 내놓은 판단을 많이 모았을 때 실제로도 약 90%가 맞아야 한다는 뜻이다. 개별 답 하나가 반드시 맞는다는 뜻은 아니다. Jev는 이를 학습 목표로 삼았다고 설명하지만, 내 데이터에서도 맞는지는 별도로 확인해야 한다.
작은 판단이 많아지면 시간과 비용도 커진다
섹션 제목: “작은 판단이 많아지면 시간과 비용도 커진다”고객 문의 한 건에는 팀 분류뿐 아니라 긴급도·환불 요청 여부 같은 질문이 함께 붙는다. Jev는 같은 입력에 대한 여러 질문을 한 요청에서 병렬로 평가한다. 공식 설명은 질문을 추가해도 지연 증가가 작다고 소개한다. 추가 질문의 입력 비용까지 없어지는 것은 아니다.
출시 글은 자체 workflow 평가에서 최대 193.6배 빠르고 444.6배 저렴했다고 주장한다. 다만 글 자체가 실제 이득의 상한으로 제시한 벤더 측정값이다. 출시 벤치마크의 배율을 내 업무의 예상 성능으로 쓰면 안 된다.
해법: 빠른 판단에 집중하는 System One 모델
섹션 제목: “해법: 빠른 판단에 집중하는 System One 모델”System One은 TypeSafe가 붙인 모델 부류의 이름이다. 빠른 직관을 뜻하는 카너먼의 System 1에서 이름을 가져왔다. “충분한 재료를 보고 빠르게 내릴 수 있는 좁은 판단”에 집중한다는 의미로 읽으면 된다. 공식 개념 문서
예를 들어 “이 문의는 결제 문제인가?”는 좁은 질문이다. “고객을 만족시키면서 손실도 줄일 최선의 대응을 세워라”는 여러 조건을 따져야 하는 열린 문제다. 후자는 질문을 나누거나 LLM의 추론을 써야 한다.
학습 방법의 이름은 **RLCD(Reinforcement Learning for Calibrated Decisions)**다. 확률이 실제 결과와 맞도록 학습한다는 TypeSafe의 설명이다. 여기서 기억할 것은 약어보다 그럴듯한 말투 대신 코드가 사용할 판단 값과 불확실성에 집중한다는 설계 방향이다. 학습 목표 설명
주요 개념: 같은 고객 문의에 세 가지 질문을 한다
섹션 제목: “주요 개념: 같은 고객 문의에 세 가지 질문을 한다”state — 판단할 재료를 준다
섹션 제목: “state — 판단할 재료를 준다”“두 번 결제됐어요. 한 번은 환불해 주세요”라는 문의와 주문 기록을 입력으로 준다고 하자.
이 재료를 state라고 한다. 질문은 별도로 적는다. 입력이 같은 경우 여러 질문이 같은 state를 본다.
State 문서
관련 없는 대화 전체를 붙이기보다 판단에 필요한 내용만 주는 편이 낫다. 예를 들어 환불 정책에 맞는지를 물으려면 고객 문장만이 아니라 해당 정책과 결제 기록도 필요하다.
Choice · Score · Noul — 답의 모양을 정한다
섹션 제목: “Choice · Score · Noul — 답의 모양을 정한다”공식 질문 문서는 세 형식을 제공한다.
| 형식 | 고객 문의에 묻는 질문 | 받는 답 |
|---|---|---|
| Choice | 결제팀·기술팀·영업팀 중 어디 담당인가? | 선택한 팀과 각 선택지의 확률 |
| Score | 차분함·불만·매우 화남 중 어느 수준인가? | 정한 등급 위의 점수와 등급별 확률 |
| Noul | 고객이 환불을 요청했는가? | “그렇다”의 확률 하나 |
Choice는 종류를 고르고, Score는 정도를 매긴다. Score는 등급 사이의 소수 값도 낼 수 있다. Noul의 0.5는 “환불을 절반만 요청했다”가 아니라 참·거짓을 비슷하게 본다는 뜻이다. Noul이라는 이름의 어원은 공식 문서에 없어 추측하지 않는다.
질문마다 instructions에 판단할 내용을 적는다. Choice와 Score의 criteria에는 선택지와 등급을 정의한다.
서로 다른 질문은 독립적으로 평가하므로 “앞 질문의 답을 보고 다음 질문에 답하라”는 식으로 생각하면 안 된다.
필요한 답의 조합은 코드에서 처리한다.
probabilities와 confidence — 가능성과 쏠림을 구별한다
섹션 제목: “probabilities와 confidence — 가능성과 쏠림을 구별한다”다음은 읽는 법을 설명하기 위한 값이다.
| 필드 | 예시 | 읽는 법 |
|---|---|---|
choice | technical | 선택한 답은 기술팀이다 |
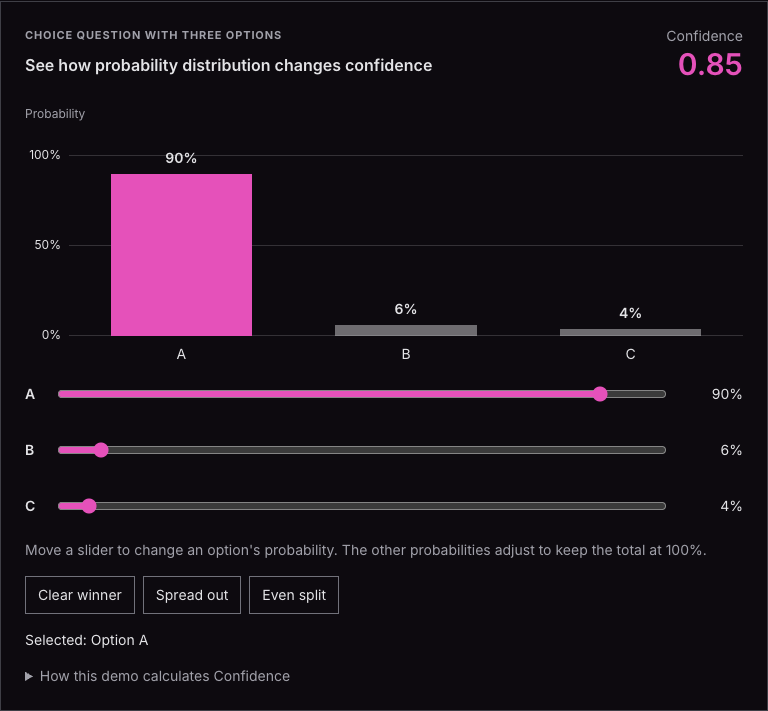
probabilities | 결제팀 0.05 · 기술팀 0.90 · 영업팀 0.05 | 모델이 각 선택지에 부여한 확률이다 |
confidence | 0.85 | 확률 분포가 한 선택지에 얼마나 모였는지 요약한 값이다 |
confidence 0.85를 “정답일 확률 85%”로 읽지 않는다.
Confidence 문서의 세 선택지 데모는
(3 × 가장 큰 확률 − 1) / 2로 근사한다. 위 값은 이 데모 계산을 따른 예시이며,
모든 질문 형식의 공식 계산식을 뜻하지 않는다. Noul은 확률 자체가 답이므로 별도 confidence가 없다.
예제: 문의를 읽고 담당 팀을 정한다
섹션 제목: “예제: 문의를 읽고 담당 팀을 정한다”아래 JSON은 공식 질문 형식을 단순화한 설명용 요청·응답이다. API를 실행해 얻은 결과가 아니며, 확률은 읽는 법을 보여 주기 위해 넣은 값이다.
{ "model": "jev-latest", "state": "Our API returns 500 errors; can't process orders.", "questions": { "department": { "type": "choice", "instructions": "Which team should handle this?", "criteria": { "billing": "Payment issues", "technical": "Bugs or integration problems", "sales": "Pricing questions" } }, "is_urgent": { "type": "noul", "instructions": "Does the message convey urgency?" } }}{ "answers": { "department": { "choice": "technical", "probabilities": { "billing": 0.05, "technical": 0.90, "sales": 0.05 }, "confidence": 0.85 }, "is_urgent": { "noul": 0.92 } }}문의는 “API 오류로 주문을 처리할 수 없다”는 내용이다. 설명용 정책을 팀 배정은 confidence 0.8 이상, 긴급 표시는 Noul 0.9 이상으로 정했다면, 위 응답은 기술팀에 배정하고 긴급 표시를 하는 경로로 간다. 팀 배정 기준을 0.9로 올리면 같은 응답이 사람 검토로 간다. 값이 행동을 결정하는 것은 정책과 함께일 때다.
이 임계값은 설명용이지 권장 기본값이 아니다. 실제 기준은 오분류 비용과 내 데이터의 결과로 정한다. 공식 confidence 예제도 고위험 작업에는 사용자 확인을 포함한다.
LLM·일반 코드와의 역할 분담
섹션 제목: “LLM·일반 코드와의 역할 분담”| 필요한 일 | 맡길 곳 | 이유 |
|---|---|---|
| 고객에게 보낼 답장 작성 | LLM | 답의 문장이 미리 정해져 있지 않다 |
| 문의 분류·불만 수준 판단 | Jev가 겨냥하는 자리 | 정한 선택지나 등급으로 답할 수 있다 |
| 결제 합계 계산·날짜 비교 | 일반 코드 | 정확한 계산과 규칙으로 처리할 수 있다 |
| 티켓 배정·환불 실행 | 애플리케이션과 외부 서비스 | 모델의 판단 뒤에 권한·업무 규칙을 적용해야 한다 |
같은 원리로 요청에 맞는 모델 고르기, 검색 문단의 관련성 판단, 도구 호출의 위험 신호 분류에도 쓸 수 있다. 공식 패턴 문서는 이런 조합을 다룬다. 다만 모델의 위험 점수를 접근 권한이나 실행 허가 자체로 사용해서는 안 된다.
한계와 흔한 오해
섹션 제목: “한계와 흔한 오해”형식이 맞는 답도 틀릴 수 있다
섹션 제목: “형식이 맞는 답도 틀릴 수 있다”선택지가 결제팀·기술팀·영업팀뿐이면 그 밖의 팀 이름을 만들어 내지 않는다.
하지만 결제 문의를 기술팀으로 잘못 고를 수 있다.
TypeSafe의 “hallucination이 없다”는 표현은 이런 출력 범위 제한과 구별해 읽어야 한다.
질문 문서는 선택지가 모든 입력을 덮지 못하면 other 같은 항목을 두도록 안내한다.
정확한 계산과 적대적 입력에 강한 모델은 아니다
섹션 제목: “정확한 계산과 적대적 입력에 강한 모델은 아니다”Jev 1.13의 공식 한계 문서는 개수 세기·날짜 비교·복잡한 부정문·큰 무관한 입력에 약점이 있다고 밝힌다. 또한 입력에 섞인 공격성 지시가 판단을 흔들 수 있다고 설명한다. 따라서 “빠른 판단 모델”이라는 말만으로 보안 판정의 정확성까지 보장된다고 볼 수 없다.
계산은 코드로 옮기고, 모델에는 한 번에 하나의 명확한 질문을 준다. 모순 관계인 질문 두 개를 따로 물었다고 확률의 합이 반드시 1이 되는 것도 아니다.
공개 수치와 내 업무의 결과는 다르다
섹션 제목: “공개 수치와 내 업무의 결과는 다르다”모델 문서의 기준 모델은 Jev 1.13.0이며 jev-latest는 이동하는 별칭이다.
텍스트만 받고, 요청 전체는 64k 토큰, state와 가장 긴 질문의 합은 32k 토큰 제한을 둔다.
영어가 주 학습 언어이므로 한국어 품질은 별도로 확인해야 한다.
이 노트는 API 성능·확률 보정·한국어 정확도를 측정하지 않았다.
이해 확인
섹션 제목: “이해 확인”“고객 메일에서 주문 번호를 뽑고, 결제 합계를 계산하고, 담당 팀을 정해 달라”를 모두 Jev에 맡길 수 있을까?
주문 번호처럼 열린 값은 코드나 생성 모델로 후보를 찾고, 합계는 코드로 계산한다. 담당 팀은 정한 선택지에서 고르는 질문으로 만들 수 있다. 어떤 답의 모양이 필요한지가 역할을 나누는 기준이다.
기준 시점과 확인 범위
섹션 제목: “기준 시점과 확인 범위”- 확인일: 2026-09-29.
- 기준: Jev 1.13.0, TypeSafe의 출시 글·System One·State·Primitives·Confidence·AI primer·모델 한계 문서.
- 확인한 것: 판단 전용 모델이라는 문제의식, 질문 형식, 확률과 confidence의 차이, 입력 제한과 공개된 약점.
- 확인하지 않은 것: API 호출, 속도·비용·정확도 측정, 한국어 품질. JSON과 임계값은 설명용이다.