Host가 driver 소유
driver.enabled=false를 사용한다.
DGX OS update와 Kubernetes drain·reboot 순서를 함께 운영한다.
GPU Operator는 GPU를 나눠 주는 scheduler가 아니라 GPU node의 software stack을 맞추는 자동화다
operand피연산 구성요소device pluginCDIContainer Device InterfaceGFDGPU Feature DiscoveryMIGMulti-Instance GPU
위에서 InferenceService가 GPU 한 장을 요구해도 아래 사슬이 준비되지 않으면 Pod는 실행되지 않는다.
GPU Operator는 이 사슬을 node마다 같은 정책으로 설치·검증·업그레이드한다.
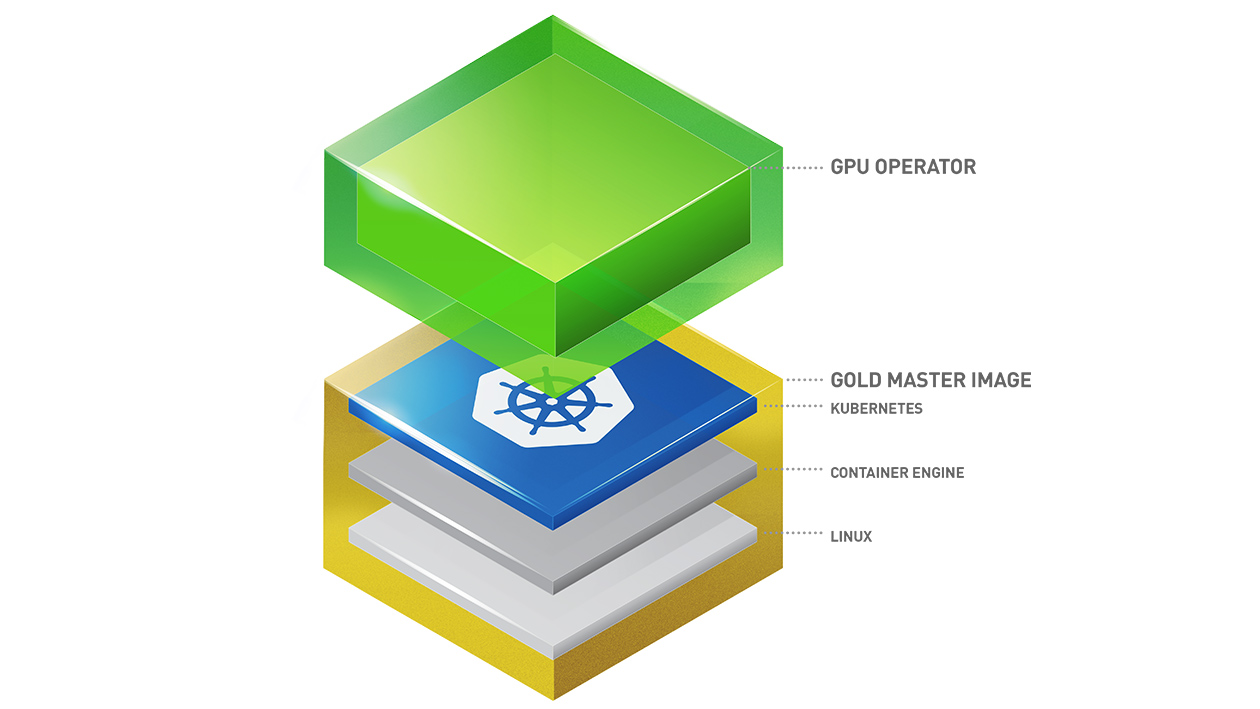
gpu-operator controller Pod 하나가 모든 일을 직접 처리하는 것은 아니다. ClusterPolicy 같은 원하는
상태를 읽고, 각 node에 필요한 DaemonSet·Deployment를 만든다.
| component | 어디에서 무엇을 하나 | 없거나 깨지면 보이는 증상 |
|---|---|---|
| NVIDIA driver | host kernel과 GPU 사이 | host nvidia-smi 실패, CUDA 초기화 실패 |
| Container Toolkit·CDI | containerd가 GPU device·library를 container에 연결 | Pod는 떠도 GPU가 안 보이거나 runtime 생성 실패 |
| NVIDIA device plugin | GPU를 kubelet의 extended resource로 광고 | nvidia.com/gpu가 Allocatable에 없음 |
| Node Feature Discovery | CPU architecture·PCI 같은 일반 hardware label 생성 | node 선택 정책의 기반 label 누락 |
| GPU Feature Discovery | GPU 제품·capability·MIG label 생성 | A100·B300·MIG placement 구분 불가 |
| MIG Manager | node의 MIG geometry를 원하는 profile로 맞춤 | MIG resource 이름·개수가 기대와 다름 |
| DCGM Exporter | GPU health·memory·activity metric 노출 | Prometheus에서 GPU 상태를 볼 수 없음 |
| validator | driver·toolkit·device plugin 경로를 시험 | 설치는 Running인데 실제 CUDA가 안 되는 상태를 놓침 |
여기서 GPU Operator는 scheduler를 대신하지 않는다. scheduler는 device plugin이 광고한 개수와 node label·taint를 보고 node를 고른다. model의 실제 memory 요구나 tensor parallel 효율은 이해하지 못한다.
DGX 계열은 host image에 driver와 toolkit이 이미 있을 수 있다. 무조건 Operator가 다시 설치하면 kernel· driver·CRI 설정의 주인이 둘이 된다.
Host가 driver 소유
driver.enabled=false를 사용한다.
DGX OS update와 Kubernetes drain·reboot 순서를 함께 운영한다.
Operator가 driver 소유
driver container 또는 NVIDIADriver CR을 사용한다.
node pool별 kernel·driver 지원과 upgrade policy를 고정한다.
Toolkit도 별도 결정
Docker에서 GPU가 보이는 것과 Kubernetes의 containerd·CDI가 준비된 것은 다르다.
CRI 경로를 실제 Pod로 확인한 뒤에만 toolkit.enabled=false로 둔다.
Spark·A100·B300의 driver 주인이 다르면 한 ClusterPolicy 값으로 억지로 통일하지 않는다. node selector가
있는 NVIDIADriver CR을 쓰거나 실행 cluster를 분리해 한 세대의 upgrade가 다른 세대를 재부팅하지 않게 한다.
A100의 MIG를 켜면 device plugin이 nvidia.com/gpu 대신 strategy에 따른 MIG extended resource를 광고한다.
중요한 결정은 “MIG 기능을 켰는가”가 아니라 사용자에게 어떤 고정 크기의 GPU 상품을 약속하는가다.
a100-full → 큰 LLM, 전체 GPU memory와 fault domaina100-mig-1g → 작은 embedding·reranker, 고정된 작은 instancea100-mig-3g → 중형 model, 더 큰 memory profileMIG geometry를 바꾸면 실행 중 workload와 GPU reset 조건이 얽힌다. 초기에는 node별 geometry를 고정하고 변경을 maintenance로 취급한다. time-slicing은 memory·fault isolation이 없으므로 MIG와 같은 상품으로 설명하지 않는다.
nvidia-smi 결과를 기록한다.Capacity와 Allocatable에 GPU·MIG resource가 정확히 나타나는지 확인한다.accelerator.* 운영 label을 비교한다.host driver → Container Toolkit · CDI → device plugin · Allocatable → scheduler placement → container의 CUDA → DCGM health| 증상 | 첫 확인 |
|---|---|
Pod가 Pending | resource request, Allocatable, label·taint·affinity |
| container 생성 실패 | containerd event, CDI spec, toolkit validator |
| Pod는 Running인데 CUDA 실패 | 할당된 device, image의 CUDA compatibility, driver |
| GPU 개수·MIG profile이 이상함 | device plugin strategy, MIG Manager state·label |
| 간헐적 오류·restart | DCGM XID·ECC·temperature, kubelet·driver log |
최소 확인 명령은 다음 네 개로 시작한다.
kubectl get nodes -L kubernetes.io/arch,nvidia.com/gpu.product,nvidia.com/mig.strategy,accelerator.poolkubectl describe node a100-01kubectl -n gpu-operator get pods -o widekubectl get runtimeclass