6. search_runs로 조건 걸기
이 장에서 처음 나오는 말3개
filter string- SQL의 WHERE절을 닮은 조건 문자열.
metrics.sharpe_net > 0.8같은 형태다. 필드 접두어- 무엇을 거를지 가리키는 앞부분.
metrics.·params.·tags.·attributes.·datasets.다섯이다. order_by- 정렬 기준 목록.
["metrics.sharpe_net DESC"]처럼 문자열로 준다.
조건 하나의 구조
섹션 제목: “조건 하나의 구조”필터는 필드 · 연산자 · 값 세 조각이다.
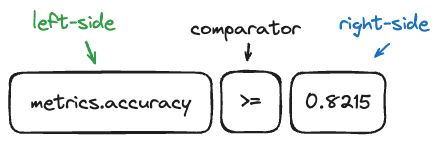
필드는 다섯 종류다.
| 접두어 | 무엇을 거르나 | 값의 종류 |
|---|---|---|
metrics. | 실행 결과 수치 | 실수 — 부등호가 그대로 먹는다 |
params. | 실행 조건 | 문자열 — 등가·LIKE만 |
tags. | 분류·메모 | 문자열 |
attributes. | run 자체의 속성 (run_name·status·run_id·시각) | 문자열 |
datasets. | 연결된 데이터셋 (name·digest·context) | 문자열 |
연산자는 값의 종류를 따른다.
- 숫자:
=!=>>=<<= - 문자열:
=!=LIKE(대소문자 구분)ILIKE(구분 안 함) - 없음 확인:
IS NULL·IS NOT NULL— tag와 param에만 쓴다 - 목록:
IN—datasets와attributes.run_id에만 쓴다
실제로 쓰는 형태
섹션 제목: “실제로 쓰는 형태”mlflow.search_runs()는 기본으로 pandas DataFrame을 돌려준다. sshim-trader의 실제 DB에 던져 보면
열이 run_id·experiment_id·status·artifact_uri·start_time·end_time 다음에
metrics.*·params.*·tags.*가 이어진다.
import mlflow
mlflow.set_tracking_uri("sqlite:///artifacts/mlflow.db")
df = mlflow.search_runs( experiment_names=["research/tune_o2n"], filter_string="tags.phase = 'tune' and metrics.sharpe_net > 0.5", order_by=["metrics.sharpe_net DESC"], max_results=20,)df[["tags.mlflow.runName", "metrics.sharpe_net", "params.lgbm.num_leaves"]]experiment_names를 쓰면 experiment id를 몰라도 된다. 여러 experiment를 한 번에 보려면 목록으로 주고,
전체를 훑을 때는 search_all_experiments=True를 쓴다.
sshim-trader에서 바로 쓸 질의들
섹션 제목: “sshim-trader에서 바로 쓸 질의들”# 1) 최종 검증 런만 — 튜닝 trial을 걷어낸다"tags.phase = 'final'"
# 2) 채택 후보 — holdout에서도 버틴 것"metrics.holdout_sharpe_net > 0.8 and metrics.holdout_mdd > -0.25"
# 3) 특정 재학습 주기만 — param은 문자열이라 등가 비교"params.step_days = '120'"
# 4) 같은 데이터셋으로 돌린 것만"params.dataset = 'chart-nxt_day_202608'"
# 5) 특정 study의 trial 전체"tags.study = 'nxt_daily_o2n' and tags.phase = 'tune'"
# 6) 아직 판단을 안 붙인 런 — 3장에서 만든 decision tag가 없는 것"tags.decision IS NULL"
# 7) 이름 규칙으로 거르기"attributes.run_name LIKE 'nxt_daily_o2n_final_%'"metrics.holdout_mdd > -0.25가 부등호 방향이 뒤집힌 것처럼 보이는데 맞다. MDD는 음수이므로
“덜 깊은 낙폭”이 더 큰 값이다. metric의 부호 규약을 아는 사람만 쓸 수 있는 조건이라,
이런 질의는 스크립트에 주석과 함께 굳혀 두는 편이 낫다.
UI에서 하던 판단을 스크립트로
섹션 제목: “UI에서 하던 판단을 스크립트로”5장의 “튜닝 결과 읽는 순서”를 그대로 코드로 옮기면 매번 같은 기준으로 볼 수 있다.
import mlflow
mlflow.set_tracking_uri("sqlite:///artifacts/mlflow.db")
final = mlflow.search_runs(    experiment_names=["research/tune_o2n"],    filter_string="tags.phase = 'final'",)cols = ["tags.variant", "metrics.sharpe_net", "metrics.holdout_sharpe_net", "metrics.holdout_mdd"]table = final[cols].set_index("tags.variant")
# 튜닝 구간에서만 좋아지고 holdout에서 무너졌는지 한 줄로 확인한다table["overfit_gap"] = table["metrics.sharpe_net"] - table["metrics.holdout_sharpe_net"]print(table.round(3))overfit_gap은 MLflow가 주는 값이 아니라 여기서 만든 파생값이다. 이렇게 검색 결과를 DataFrame으로 받아
내가 아는 판단 규칙을 얹는 것이 이 도구의 실제 사용 방식이다.
여기서 한 걸음 더 나가면 4장의 artifact 회수와 이어진다.
top3 = mlflow.search_runs( experiment_names=["research/nxt_daily_o2n"], order_by=["metrics.sharpe_net DESC"], max_results=3,)for run_id in top3["run_id"]: path = mlflow.artifacts.download_artifacts(run_id=run_id, artifact_path="daily_net_returns.csv") ... # 세 런의 일별 수익을 한 그래프에 겹친다런이 아주 많아지면
섹션 제목: “런이 아주 많아지면”search_runs는 결과를 한 번에 메모리로 올린다. 기본 max_results가 100000이라 지금 규모에서는
신경 쓸 일이 없지만, trial을 수천 개씩 돌리기 시작하면 MlflowClient.search_runs의 페이지 단위 호출로 바꾼다.
from mlflow import MlflowClient
client = MlflowClient("sqlite:///artifacts/mlflow.db")page = client.search_runs(experiment_ids=["2"], max_results=500)while True:    for run in page:        ...    if page.token is None:      # 마지막 페이지 — token 확인 없이 돌리면 첫 페이지로 되돌아가 무한 루프다        break    page = client.search_runs(experiment_ids=["2"], max_results=500, page_token=page.token)
모델을 기록하기 시작하면 짝이 되는 API가 하나 더 생긴다. mlflow.search_logged_models()는
run이 아니라 모델을 조건으로 찾고, 역시 DataFrame을 돌려준다. 8장에서 쓴다.