11. DB와 artifact를 관리하기
이 장에서 처음 나오는 말4개
soft delete- 지웠다고 표시만 하고 데이터는 남기는 삭제. MLflow UI의 삭제가 이것이다.
gcgarbage collection- 표시만 된 것을 실제로 지우는 정리 작업.
schema migration스키마 이전- MLflow 버전이 올라 DB 표 구조가 바뀔 때 기존 DB를 새 구조로 옮기는 일.
write lock쓰기 잠금- sqlite가 한 번에 한 쓰기만 허용하는 성질. 병렬 기록에서 오류가 난다.
얼마나 커지나
섹션 제목: “얼마나 커지나”지금 sshim-trader의 실측은 이렇다.
| 대상 | 크기 | 런당 |
|---|---|---|
artifacts/mlflow.db | 916KB (런 6개) | 수 KB — metadata는 사실상 무시할 수 있다 |
artifacts/mlruns/ | 22MB (artifact가 붙은 런 2개) | 약 11MB |
metadata는 문제가 아니다. 문제는 artifact다. 백테스트·연구 런을 백 번 돌리면 1GB가 넘고,
대부분은 predictions.parquet이다. 4장에서 “무엇을 올릴지 고른다”고 한 이유가 여기 있다.
튜닝 trial은 artifact를 붙이지 않으므로(research_tune.py가 artifact_paths를 넘기지 않는다)
trial을 아무리 많이 돌려도 디스크는 거의 안 는다. 이게 좋은 기본값이니 유지한다.
지웠는데 안 지워진다
섹션 제목: “지웠는데 안 지워진다”UI에서 런을 지우면 lifecycle_stage가 deleted로 바뀔 뿐이다. 행도 파일도 그대로 있고,
search_runs에서만 안 보인다(run_view_type을 ALL로 바꾸면 다시 보인다).
실제로 지우려면 두 단계다.
-
먼저 지울 것을 표시한다. UI에서 하거나 CLI로 한다.
터미널 창 uv run mlflow runs delete --run-id <run_id> -
그다음 정리한다. 되돌릴 수 없다.
터미널 창 uv run mlflow gc --backend-store-uri sqlite:///artifacts/mlflow.db
mlflow gc는 deleted 단계의 런에 대해 metadata(param·metric·tag)와 artifact 파일을 함께 지운다.
artifact URI가 유효하지 않으면 파일 삭제는 건너뛰고 계속 진행하므로, 2장에서 본
“레포를 옮기면 절대 경로가 깨진다” 문제가 있으면 DB 행만 지워지고 파일은 고아로 남는다.
sqlite의 진짜 제약 — 동시 쓰기
섹션 제목: “sqlite의 진짜 제약 — 동시 쓰기”sqlite는 읽기는 여럿, 쓰기는 한 번에 하나다. 지금 구성에서 이게 드러나는 자리가 하나 있다.
Optuna를 study.optimize(objective, n_jobs=4)로 병렬화하면 trial 4개가 동시에 log_run()을 부른다.
그러면 database is locked 오류가 날 수 있다. 7장에서 짚은
“활성 run은 스레드마다 따로다” 문제와 겹쳐서, 병렬 튜닝은 두 가지를 동시에 건드린다.
지금은 순차 실행이라 문제가 없다. 병렬로 갈 때의 선택지는 셋이다.
| 방법 | 성격 |
|---|---|
| 기록만 순차로 모아 마지막에 한 번에 | 코드가 복잡해진다 |
| tracking server를 띄워 그쪽이 DB를 독점 | 아래 절의 구성 |
| backend store를 PostgreSQL로 | 지금 규모에는 과하다 |
MLflow를 올릴 때
섹션 제목: “MLflow를 올릴 때”MLflow 버전이 오르면 DB 스키마가 바뀔 수 있다. 서버를 띄우기 전에 먼저 이전한다.
uv run mlflow db upgrade sqlite:///artifacts/mlflow.db이 레포에는 조건이 하나 더 붙는다. pyproject.toml의 override-dependencies = ["pandas>=3.0.1"]는
MLflow의 pandas<3 상한을 강제로 무시하는 설정이다. AGENTS.md도 “관련 추적 경로를 검증하지 않고
이 override를 제거하지 않는다”고 못 박아 뒀다. 그러니 MLflow를 올릴 때는 순서가 있다.
-
artifacts/mlflow.db를 복사해 둔다. -
버전을 올리고
uv sync로 잠금을 갱신한다. -
uv run mlflow db upgrade sqlite:///artifacts/mlflow.db를 돌린다. -
실제로 쓰는 경로를 확인한다 —
log_params·log_metrics·log_artifacts· UI 열기. pandas 상한을 무시한 조합이므로 “설치가 됐다”가 “동작한다”를 뜻하지 않는다. -
뭔가 이상하면 진단 명령이 있다.
터미널 창 uv run mlflow doctor
나중에 서버로 옮긴다면
섹션 제목: “나중에 서버로 옮긴다면”지금 구성으로 부족해지는 순간은 분명하다. 두 번째 기기에서도 같은 기록을 보고 싶을 때, 또는 병렬 실행이 필요할 때다. 그때는 client가 파일에 직접 쓰는 대신 HTTP 서버에 쓴다.
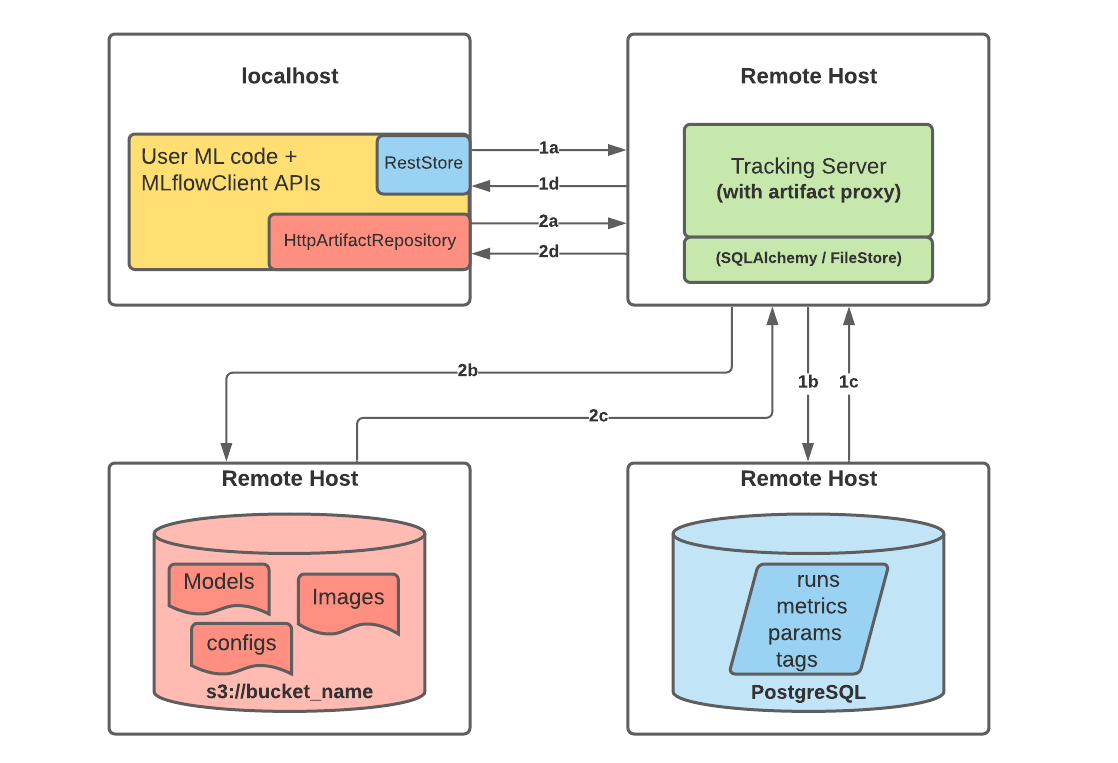
바뀌는 것과 안 바뀌는 것을 구분해 두면 그때 덜 헤맨다.
| 항목 | 로컬 (지금) | 서버로 옮긴 뒤 |
|---|---|---|
| tracking URI | sqlite:///artifacts/mlflow.db | http://<host>:5000 |
| backend store | client가 직접 sqlite에 쓴다 | 서버만 DB에 접근한다 |
| artifact 위치 | experiment마다 로컬 절대 경로 | 서버의 --default-artifact-root 또는 object storage |
| 로깅 코드 | log_params · log_metrics · log_artifacts | 그대로다 |
| 검색 코드 | search_runs(...) | 그대로다 |
로깅과 검색 코드가 그대로라는 게 이 도구의 좋은 점이다. 다만 기존 experiment의 artifact_location은
따라오지 않는다. 2장에서 본 대로 그 값은 생성 시점에 박히고, 지금 DB에는
/Users/sshim/workspace/sshim-trader/artifacts/mlruns가 들어 있다. 서버가 그 경로에 접근할 수 없으면
옛 런의 artifact만 못 여는 상태가 된다. 옮길 때는 기존 런을 아카이브로 두고 새 experiment로
시작하는 편이 단순하다.
지금 굳혀 둘 습관
섹션 제목: “지금 굳혀 둘 습관”서버로 갈 일이 없더라도 지금 해 두면 나중이 편한 것들이다.
- 레포 루트에서만 실행한다. tracking URI가 상대 경로다(2장).
artifacts/가.gitignore에 들어 있는지 확인한다. sqlite 파일과 22MB짜리 artifact는 커밋 대상이 아니다.mlflow.db를 가끔 복사해 둔다. 이 파일이 사라지면 어떤 조건으로 무엇이 나왔는지가 통째로 사라진다. artifact 폴더와 달리 원본이 없다.- experiment 이름 규칙을 바꾸지 않는다.
artifact_location을 다시 정할 방법이 없다.