10. 6개월 뒤 이 런을 다시 만들 수 있는가
이 장에서 처음 나오는 말4개
digest지문- 데이터 내용으로 계산한 짧은 해시. 파일 이름이 같아도 내용이 바뀌면 값이 달라진다.
dirty 작업 트리- 커밋하지 않은 수정이 남아 있는 상태. 커밋 해시만으로는 그때 코드를 복원할 수 없다.
log_input- 이 run이 어떤 데이터를 썼는지 dataset으로 연결하는 API다.
seed난수 시드- 난수 생성의 출발점. 같은 seed면 같은 순서의 난수가 나온다.
재현을 막는 네 가지
섹션 제목: “재현을 막는 네 가지”“두 달 전 그 결과가 다시 안 나온다”의 원인은 대체로 넷 중 하나다. 지금 sshim-trader가 각각을 어디까지 잡고 있는지 먼저 정리한다.
| 축 | 지금 상태 | 빠진 것 |
|---|---|---|
| 코드 | mlflow.source.git.commit이 자동으로 붙는다 | 미커밋 변경은 잡히지 않는다 |
| 데이터 | dataset param에 폴더 이름이 남는다 | 같은 폴더의 내용이 바뀌면 알 수 없다 |
| 난수 | LGBM random_state=42가 param에 남는다 | 평가·탐색 쪽 seed는 기록되지 않는다 |
| 환경 | 없다 | Python·MLflow·LightGBM·pandas 버전이 어디에도 없다 |
코드 — 커밋 해시만으로는 부족하다
섹션 제목: “코드 — 커밋 해시만으로는 부족하다”git 작업 트리 안에서 실행하면 MLflow가 mlflow.source.git.commit·branch·repoURL을 알아서 채운다.
sshim-trader의 실제 DB에 이 tag가 들어 있으므로 이미 동작하고 있다.
문제는 연구 중에는 거의 항상 커밋하지 않은 상태라는 것이다. 피처 하나를 고쳐 보고 결과를 보는 게 연구인데, 그 시점의 커밋 해시는 수정 이전을 가리킨다. 해시는 있는데 그 해시로 되돌리면 다른 코드가 나온다.
한 줄로 표시할 수 있다.
import subprocess
dirty = bool(subprocess.run(["git", "status", "--porcelain"], capture_output=True, text=True).stdout.strip())mlflow.set_tag("git_dirty", str(dirty))git_dirty=True인 런은 “결과는 참고하되 재현은 보장 못 함”으로 읽는다. 검색으로 거를 수도 있다 —
tags.git_dirty = 'False'가 신뢰할 수 있는 런의 집합이다. 채택을 결정하는 최종 검증은 항상
커밋된 상태에서 다시 돌리면 이 tag가 그 규율을 강제해 준다.
더 나가려면 git diff를 artifact로 붙인다.
diff = subprocess.run(["git", "diff", "HEAD"], capture_output=True, text=True).stdoutif diff: mlflow.log_text(diff, "uncommitted.diff")데이터 — 폴더 이름은 내용을 보장하지 않는다
섹션 제목: “데이터 — 폴더 이름은 내용을 보장하지 않는다”지금은 params={"dataset": daily_dir.name}로 chart-nxt_day_202608이라는 이름이 남는다. 그런데
수집 스크립트를 다시 돌려 같은 폴더에 데이터를 더 채우면 이름은 그대로인데 내용이 다르다.
두 런의 param이 똑같은데 결과가 다른 상황이 되고, 원인을 찾을 단서가 없다.
MLflow의 dataset 추적이 이걸 푼다. 내용으로 digest를 계산해 함께 남긴다.
import mlflow
dataset = mlflow.data.from_pandas(    feat,    source=str(daily_dir),    name=daily_dir.name,    targets=label_col,)mlflow.log_input(dataset, context="walkforward")
실제로 계산해 보면 한 열의 값 하나만 달라져도 digest가 바뀐다.
원본 digest c2932457한 값 수정 후 digest 3905fb3aUI에서는 run에 연결된 dataset이 이름·digest·스키마·용도와 함께 보인다.
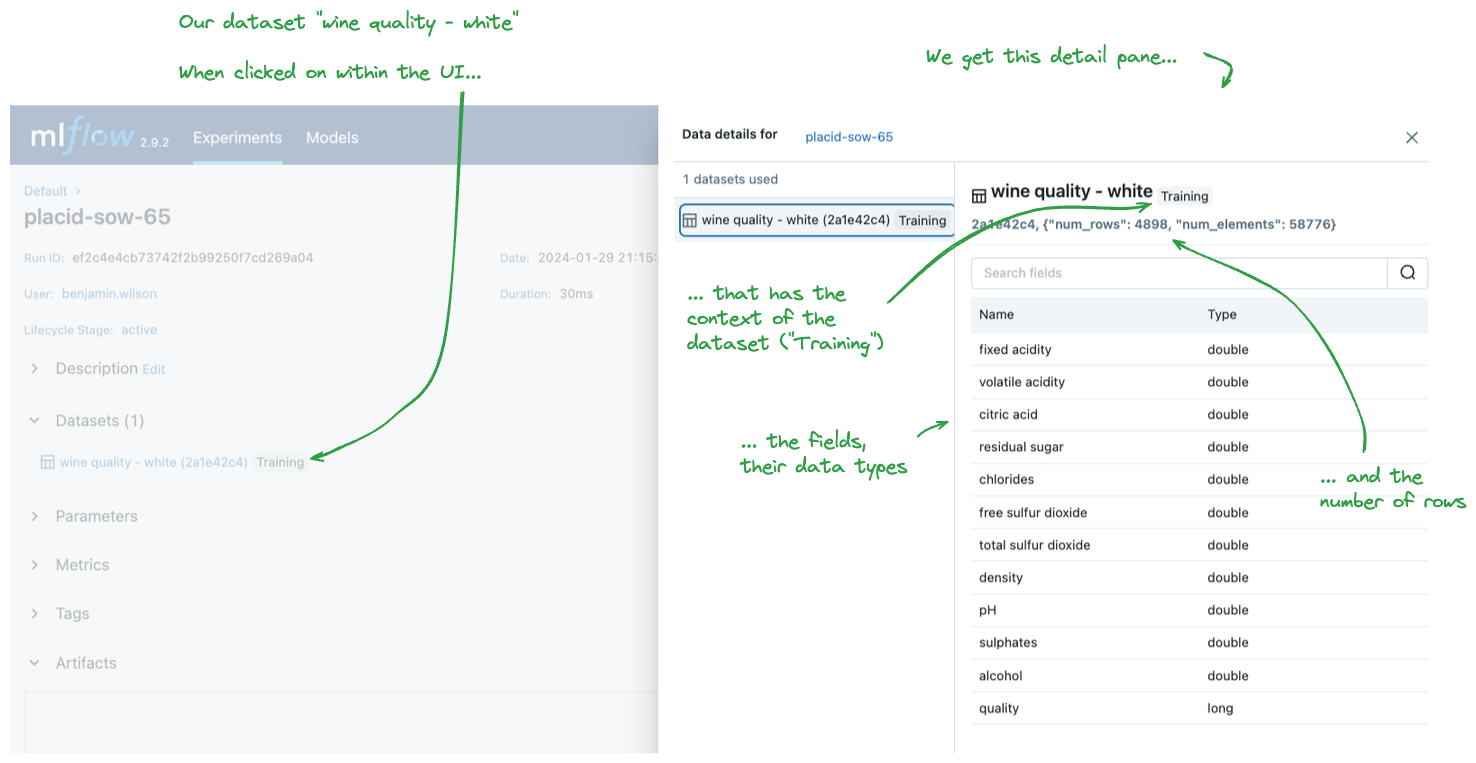
context에는 그 데이터가 무슨 역할이었는지 적는다. sshim-trader라면 walkforward·holdout·backtest 정도가 맞다.
6장의 검색에서 datasets.digest와 datasets.context를 조건으로 쓸 수 있다.
난수 — 기록되지 않는 seed가 있다
섹션 제목: “난수 — 기록되지 않는 seed가 있다”LGBM_PARAMS의 random_state=42는 param으로 남는다. 그런데 결과에 영향을 주는 seed가 더 있다.
| seed | 어디에 | 지금 기록되나 |
|---|---|---|
random_state=42 | LGBM_PARAMS | 예 — lgbm.random_state |
TPESampler(seed=42) | research_tune.py의 study 생성 | 아니오 |
random_sharpe_distribution(seed=0) | evaluate.py의 랜덤 베이스라인 | 아니오 |
n_trials=300 | 같은 함수의 랜덤 표본 수 | 아니오 |
random_sharpe_mean·random_sharpe_std는 metric으로 남는데 그 값을 만든 seed와 표본 수는 안 남는다.
z_vs_random이 이 분포를 기준으로 계산되므로, 베이스라인이 바뀌면 같은 전략의 z가 달라진다.
common params에 두 줄을 더하는 게 맞다.
common_params = { ..., "random_baseline_seed": 0, "random_baseline_trials": 300, "sampler_seed": 42,}환경 — 이 레포는 특히 취약하다
섹션 제목: “환경 — 이 레포는 특히 취약하다”pyproject.toml에 이런 주석이 있다.
# mlflow 3.x가 메타데이터상 pandas<3을 핀하지만(미갱신 상한), 이 프로젝트가 쓰는# 트래킹 경로는 pandas 3에서 동작 확인됨.[tool.uv]override-dependencies = ["pandas>=3.0.1"]즉 의존성 해석기가 정상적으로는 만들지 않을 조합을 강제로 쓰고 있다. 이런 환경일수록 “그때 무슨 버전이었나”가 나중에 중요해진다. 런마다 몇 줄만 남기면 된다.
import sys, mlflow, lightgbm, pandas, numpy
mlflow.set_tags({    "env.python": sys.version.split()[0],    "env.mlflow": mlflow.__version__,    "env.lightgbm": lightgbm.__version__,    "env.pandas": pandas.__version__,    "env.numpy": numpy.__version__,})
param이 아니라 tag로 두는 이유는 두 가지다. 실행 조건이 아니라 실행 환경이고, 나중에 정정할 수 있어야 한다.
더 확실한 방법은 lock 파일 자체를 붙이는 것이다. uv.lock은 커밋되어 있으므로 커밋 해시로도 추적되지만,
git_dirty=True인 런에서는 그 보장이 없다.
mlflow.log_artifact("uv.lock") # 필요한 런에만정리 — 런 하나에 붙을 최소 집합
섹션 제목: “정리 — 런 하나에 붙을 최소 집합”지금까지의 내용을 합치면 재현 가능한 런은 이 정도를 갖는다.
| 종류 | 항목 |
|---|---|
| 자동 | mlflow.source.git.commit · branch · mlflow.source.name · mlflow.user |
| tag | git_dirty · env.python · env.mlflow · env.lightgbm · env.pandas · out_dir |
| param | 전략 조건 전체 + sampler_seed · random_baseline_seed · random_baseline_trials |
| dataset | log_input(from_pandas(...), context="walkforward") |
| artifact | report.html · summary.csv · (필요 시) uncommitted.diff · uv.lock |
이걸 다 넣어도 log_run()은 여전히 실패를 삼킨다. 기록이 늘수록 그 계약이 더 중요해진다 —
재현 정보를 모으다가 연구가 멈추면 본말이 뒤집힌다.