7. Optuna trial을 parent/child로 묶기
이 장에서 처음 나오는 말4개
parent run부모 run- 자식 run들을 대표하는 run. 튜닝 세션 전체의 결론을 여기에 적는다.
child run자식 runstart_run(nested=True)로 만든 run.mlflow.parentRunIdtag로 부모를 가리킨다.trial- Optuna가 파라미터 한 벌을 제안해 평가한 한 번. sshim-trader 기본값은 30회다.
thread-local- "지금 열려 있는 run"이 스레드마다 따로 관리된다는 뜻. 병렬 실행에서 문제가 된다.
지금 무엇이 불편한가
섹션 제목: “지금 무엇이 불편한가”scripts/research_tune.py는 trial마다 log_run()을 부른다. 각 호출이 독립된 run을 만들므로
30회 튜닝이 끝나면 research/tune_o2n에 최상위 런이 32개 생긴다 (trial 30 + final_default + final_best).
research/tune_o2n├── nxt_daily_o2n_trial_000 ← phase=tune├── nxt_daily_o2n_trial_001├── …├── nxt_daily_o2n_trial_029├── nxt_daily_o2n_final_default ← phase=final└── nxt_daily_o2n_final_besttag 덕분에 지금도 거를 수는 있다. tags.phase = 'final'이면 결론 두 개만 나온다. 그런데 세 가지가 남는다.
- 튜닝 세션이라는 단위가 기록에 없다. 같은 study 이름으로 두 번 돌리면 60개가 섞이고, 어디까지가 어제 실행이고 어디부터가 오늘 실행인지 tag로는 못 가른다.
- 목록을 열면 항상 trial이 먼저 보인다. 결론 두 줄을 보려면 매번 필터를 건다.
- “이 튜닝의 최선값”이 어느 run에도 없다.
study.best_value는 콘솔에만 출력되고 사라진다.
공식 문서도 같은 문제를 그림으로 정리해 둔다.
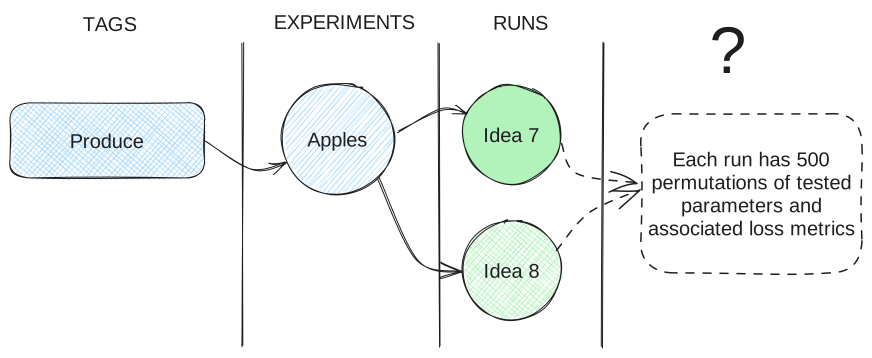
부모와 자식의 구조
섹션 제목: “부모와 자식의 구조”start_run(nested=True)로 연 run은 그 시점에 활성화된 run의 자식이 된다. MLflow가 자식에게
mlflow.parentRunId tag를 붙이고, UI는 부모 행 왼쪽의 펼침 표시로 자식을 접어 둔다.
목록에서 보이는 최상위 행은 이제 튜닝 세션당 한 개다. 두 번 돌리면 두 행이고, 각각을 펼쳐야 trial이 나온다.
부모에 best_value를 metric으로 적어 두면 metrics.best_holdout_sharpe로 세션끼리 비교할 수도 있다.
지금 코드를 어떻게 고치나
섹션 제목: “지금 코드를 어떻게 고치나”log_run()은 자기가 start_run()을 직접 부르는 구조라, 자식으로 만들려면 그 인자를 열어 줘야 한다.
가장 작은 변경은 nested 플래그 하나를 통과시키는 것이다.
with mlflow.start_run(experiment_id=exp_id, run_name=run_name, tags=tags) as run:    ...
# scripts/research_tune.py — trial마다 최상위 run이 생긴다def objective(trial):    ...    log_run(experiment=experiment, params=..., metrics=..., run_name=f"…_trial_{trial.number:03d}")    return float(lgbm["sharpe_net"])
study.optimize(objective, n_trials=args.n_trials)
# sshim_trader/utils/tracking.py — 인자 하나를 추가한다def log_run(..., nested: bool = False) -> str | None: ... with mlflow.start_run(experiment_id=exp_id, run_name=run_name, tags=tags, nested=nested) as run: ...
# scripts/research_tune.py — 부모 run 안에서 study를 돌린다mlflow.set_tracking_uri(f"sqlite:///{TRACKING_DB}")mlflow.set_experiment(experiment) # 부모도 같은 experiment에 둔다 — 다르면 UI가 접어 주지 못한다with mlflow.start_run(run_name=f"{study_name}_{datetime.now():%Y%m%d_%H%M%S}") as parent: mlflow.log_params({**common_params, "n_trials": args.n_trials})
def objective(trial): ... log_run(..., nested=True) # ← 자식이 된다 return float(lgbm["sharpe_net"])
study.optimize(objective, n_trials=args.n_trials)
# 세션의 결론을 부모에 남긴다 — 지금은 콘솔에만 찍히고 사라지는 값들이다 mlflow.log_metric("best_tune_sharpe", study.best_value) mlflow.log_params({f"best.{k}": v for k, v in study.best_params.items()}) mlflow.set_tag("best_trial", str(study.best_trial.number))phase·study·trial tag는 그대로 두는 게 좋다. 부모-자식 관계는 UI의 접힘을 만들고,
tag는 6장의 검색을 만든다. 둘은 대체 관계가 아니다.
한 가지 더. log_run()은 실패를 삼키므로, 부모 run을 여는 mlflow.start_run()을 스크립트 본문에 그냥 두면
MLflow가 죽었을 때 튜닝 전체가 죽는다. 0장의 “MLflow는 부가 기능” 계약을 지키려면
부모 run도 감싸야 한다.
import contextlib
@contextlib.contextmanagerdef optional_parent_run(run_name: str):    try:        with mlflow.start_run(run_name=run_name) as run:            yield run    except Exception:        logger.warning("MLflow 부모 run 생성 실패 — 트래킹 없이 진행한다", exc_info=True)        yield None
기성 콜백을 쓰는 길
섹션 제목: “기성 콜백을 쓰는 길”Optuna 쪽에도 통합이 있다. optuna-integration 패키지의 MLflowCallback을 study.optimize에 넘기면
trial마다 run을 자동으로 만들고, mlflow_kwargs={"nested": True}로 자식 run이 되게 할 수 있다.
# 별도 의존성이 필요하다: optuna-integration[mlflow]from optuna_integration import MLflowCallback
mlflow_cb = MLflowCallback(    tracking_uri="sqlite:///artifacts/mlflow.db",    metric_name="sharpe_net",    mlflow_kwargs={"nested": True},)study.optimize(objective, n_trials=30, callbacks=[mlflow_cb])
편하지만 이 레포에는 권하지 않는다. 콜백은 Optuna가 아는 것(제안한 파라미터와 목적값 하나)만 기록한다.
sshim-trader가 trial마다 남기는 mdd·hit_rate·z_vs_random 같은 나머지 지표와 dataset·holdout_start
같은 공통 param은 여전히 직접 넣어야 한다. 의존성 하나를 더 지는 대신 얻는 게 nested=True 한 줄이라
계산이 맞지 않는다.