8. 모델을 기록한다는 것
이 장에서 처음 나오는 말5개
MLflow Model- 모델 파일과 로딩 방법·의존성·입출력 규격을 함께 담은 표준 디렉터리 형식이다.
flavor- 이 모델을 어떤 라이브러리로 읽을지 알려주는 표식. 하나의 모델이
lightgbm과python_function두 flavor를 동시에 가질 수 있다. signature- 입력 열의 이름·타입과 출력 형태를 적어 둔 규격. 예측할 때 형식이 다르면 걸러 준다.
pyfuncpython_function- 라이브러리를 몰라도
predict()만 부르면 되는 공통 인터페이스다. autolog자동 기록- 학습 함수를 가로채 파라미터·metric·모델을 알아서 기록하는 기능이다.
지금은 모델이 남지 않는다
섹션 제목: “지금은 모델이 남지 않는다”run_walkforward()는 fold마다 LGBM을 새로 학습하고 예측만 남긴 채 모델을 버린다. 연구 단계에서는 옳다 —
보고 싶은 건 특정 모델이 아니라 “이 방식이 시간에 걸쳐 통하는가”라는 것이기 때문이다.
문제는 그다음이다. 전략을 실거래에 올리려는 순간 필요한 건 “가장 최근 창으로 학습한 모델 한 개”이고,
그건 지금 어디에도 저장되지 않는다. report.html을 보고 좋다고 판단해도, 그 판단을 실행에 옮기려면
같은 조건으로 다시 학습해야 한다. 재학습이 정확히 같은 모델을 만든다는 보장은 데이터·라이브러리
버전이 바뀌는 순간 사라진다.
MLflow Model이 담는 것
섹션 제목: “MLflow Model이 담는 것”log_model이 저장하는 건 pickle 하나가 아니라 디렉터리 한 벌이다.
디렉터리lgbm_o2n/
- MLmodel 이 모델을 어떻게 읽는지 적힌 YAML
- model.skops 직렬화된 모델 — 파일 이름은 flavor·버전에 따라 다르다 (3.15.2의 LGBMRegressor 기준)
- requirements.txt 재현에 필요한 패키지와 버전
- python_env.yaml · conda.yaml 환경 정의
- input_example.json 입력 예시 (줬을 때만)
MLmodel 파일이 핵심이다. 여기에 flavor 목록, 만든 시각, 이 모델을 만든 run_id, signature,
사용한 MLflow 버전이 들어간다. 그래서 6개월 뒤에 이 폴더만 있어도 무엇으로 어떻게 읽는지 알 수 있다.
기록과 로딩
섹션 제목: “기록과 로딩”MLflow 3의 flavor API는 artifact_path 대신 name을 받는다. 예전 인자도 아직 동작하지만
artifact_path is deprecated 경고가 뜬다.
import mlflowfrom mlflow.models import infer_signature
signature = infer_signature(X_train[FEATURE_COLS], model.predict(X_train[FEATURE_COLS]))
info = mlflow.lightgbm.log_model(    model,    name="lgbm_o2n",                       # MLflow 3 — artifact_path가 아니다    signature=signature,    input_example=X_train[FEATURE_COLS].head(5),)print(info.model_uri)   # models:/<model_id>
불러올 때는 두 가지 URI를 쓴다.
# 1) 모델 자체를 가리킨다 (MLflow 3의 LoggedModel)model = mlflow.pyfunc.load_model(f"models:/{info.model_id}")
# 2) 이 run에 붙은 그 이름의 모델model = mlflow.lightgbm.load_model(f"runs:/{run_id}/lgbm_o2n")
preds = model.predict(features[FEATURE_COLS])mlflow.pyfunc.load_model로 읽으면 LightGBM을 몰라도 predict()만 쓰면 된다. 실거래 쪽이
LightGBM에 직접 의존하지 않아도 되므로 경계가 깔끔해진다.
signature가 실제로 막아 주는 사고
섹션 제목: “signature가 실제로 막아 주는 사고”sshim-trader에서 signature의 가치는 피처 열 순서다. FEATURE_COLS는
sshim_trader/research/features.py에 있고, 학습과 예측이 같은 순서로 열을 넘긴다는 전제 위에 돌아간다.
누군가 피처를 하나 추가하면서 순서가 밀리면 LightGBM은 오류 없이 다른 값을 예측한다.
signature를 붙여 두면 로딩 후 predict() 단계에서 열 이름과 타입이 검증된다. 열이 빠졌거나 타입이
다르면 그 자리에서 예외가 난다. 조용히 틀리는 대신 시끄럽게 실패하는 쪽이 매매 코드에서는 항상 낫다.
MLflow 3의 모델 탭
섹션 제목: “MLflow 3의 모델 탭”기록하면 5장에서 비어 있던 탭이 채워진다. MLflow 3에서 모델은 run에 딸린 파일이 아니라
자체 model_id와 자기 metric을 가진 행이다.
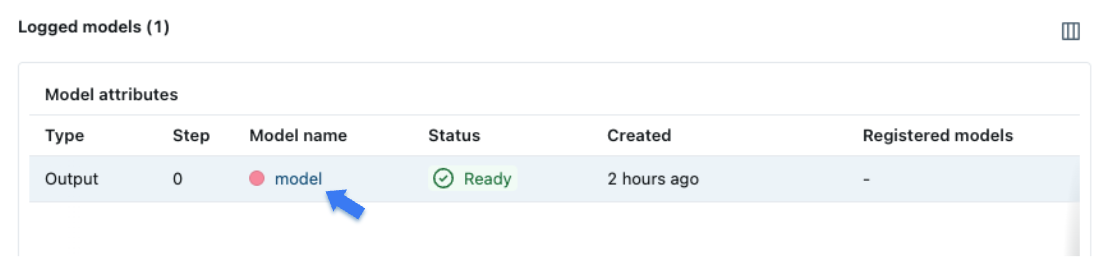
run이 아니라 모델을 조건으로 찾는 API도 따로 있다.
models = mlflow.search_logged_models( experiment_ids=["1"], order_by=[{"field_name": "creation_time", "ascending": False}],)autolog는 켜지 않는다
섹션 제목: “autolog는 켜지 않는다”mlflow.lightgbm.autolog() 한 줄이면 파라미터·feature importance·모델이 자동으로 기록된다.
튜토리얼에서는 매력적이지만 walk-forward 구조에서는 해롭다. MLflow 3.15.2에서 직접 확인한 결과다.
활성화된 run 하나 안에서 fit()을 세 번 부르면 이렇게 된다.
| 관찰 | 결과 |
|---|---|
| param 기록 | 첫 번째 학습의 값만 남는다. 두 번째부터는 Changing param values is not allowed 경고가 뜨고 무시된다 |
| 모델 | 학습 횟수만큼 LoggedModel이 생긴다 (3번 → 3개) |
| feature importance | 같은 파일 이름이라 뒤가 앞을 덮는다 |
| 시간 | 학습 자체가 1초도 안 걸리는 크기인데 기록에 매번 2초가량 더 든다 |
run_walkforward()는 한 번의 run 안에서 fold 수만큼 학습한다. 창을 750일, step을 60일로 잡으면
fold가 스무 개 남짓이므로, run 하나에 모델 20개가 쌓이고 param은 첫 fold 것만 남으며 경고가
스무 번 찍힌다. 튜닝 30 trial까지 곱하면 순수 기록 오버헤드만 수백 초다.
지금 구조에 맞는 방식은 명시적 기록이다.
- fold별 모델은 기록하지 않는다. 채택 판단에 쓰이지 않는다.
- 채택한 조건으로 전체 데이터의 마지막 창을 학습한 모델 하나만
log_model로 남긴다. - 그 모델을 실거래에 싣는 경로는 다음 장의 Model Registry가 맡는다.